统计不同单词个数:C 与 C++ 的两种写法

这道题要求统计一句话中不同单词的数量。题目本身不难,但它非常适合用来比较两种处理字符串的思路:
- C 风格:用字符数组、
fgets和strtok手动切分; - C++ 风格:用
getline、stringstream和set自动完成切分与去重。
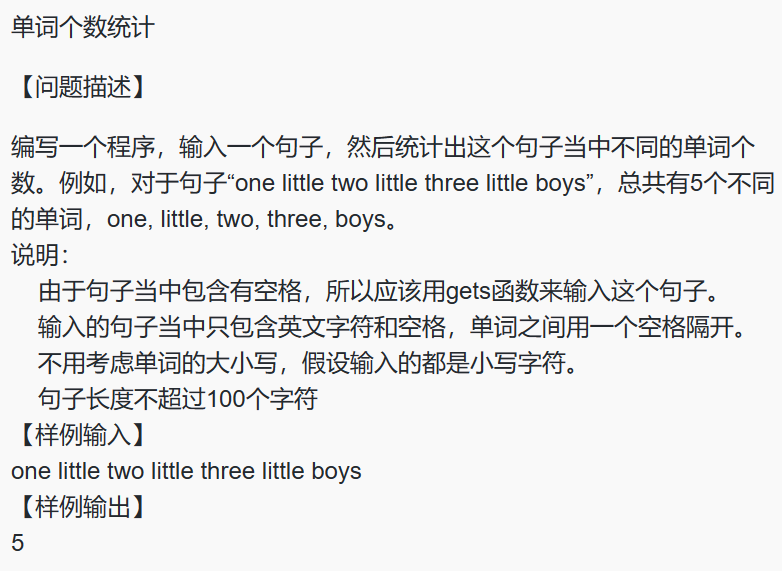
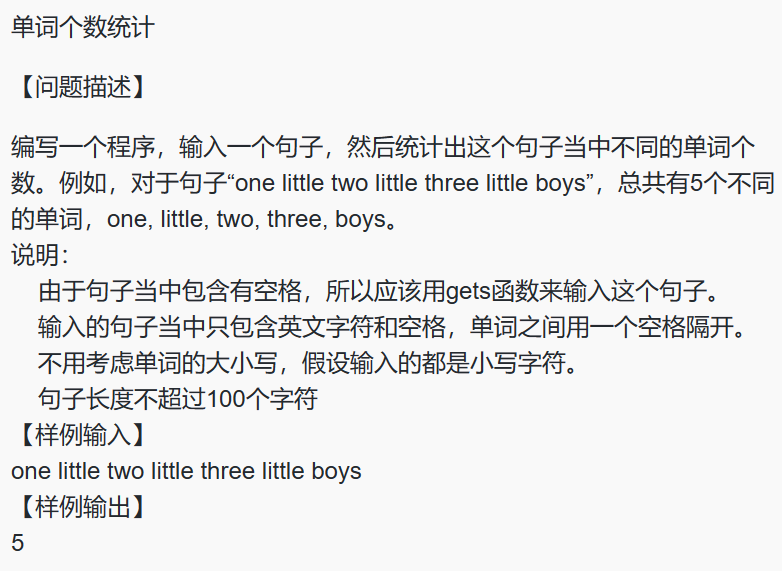
题目原文如下:
题目要求
输入一个只包含英文字符和空格的句子,统计其中不同单词的个数。
示例输入:
1 | one little two little three little boys |
示例输出:
1 | 5 |
题目说明中提到的几个条件:
- 单词之间用空格分隔;
- 不需要考虑大小写;
- 假设输入全部是小写字母;
- 句子长度不超过 100 个字符。
关于 gets
原题说明中建议使用 gets
读取整行,但这种写法不应再使用。
gets
无法限制读入长度,输入超过缓冲区大小时会覆盖其他内存,是典型的不安全函数,并已在
C11 标准中移除。
在 C 中应使用:
1 | fgets(buffer, sizeof(buffer), stdin); |
在 C++ 中应使用:
1 | std::getline(std::cin, line); |
解法一:C 语言手动切分与去重
思路
- 使用
fgets读入整行; - 使用
strtok按空白字符切分; - 将新单词与已经保存的单词逐个比较;
- 若不存在,则把它加入结果数组;
- 最后输出结果数组中的单词数量。
代码
1 |
|
说明
fgets会把换行符一起读入,但strtok的分隔符集合中包含\r和\n,因此换行符不会进入单词。words中保存的是指向line内部的指针。line在程序结束前一直有效,所以这些指针可以安全使用。- 长度为 100 的句子最多包含几十个单词,因此这里使用固定数组已经足够。
- 去重采用逐项比较,实现简单,但单词很多时效率不高。
复杂度
假设句子中有 m 个单词,单词平均长度为
L:
- 时间复杂度:最坏约为
O(m² × L); - 空间复杂度:
O(m + 输入长度)。
解法二:C++ 使用
stringstream 与 set
思路
stringstream 可以像 cin
一样,按空白字符自动读取一个个单词;set
中的元素具有唯一性,因此把单词不断插入 set
后,set 的大小就是不同单词的数量。
代码
1 |
|
为什么能自动去重
例如输入:
1 | one little two little three little boys |
依次插入后,set 中实际保存的内容是:
1 | boys |
虽然顺序被重新排列了,但题目只要求数量,因此使用 set
没有问题。
复杂度
假设输入总长度为 L,不同单词数量为 k:
- 时间复杂度:约为
O(L + k log k); - 空间复杂度:
O(L + k)。
如果只关心去重、不要求有序,也可以使用
std::unordered_set,平均时间复杂度可降为
O(L + k)。不过对于本题 100
个字符的规模,两种写法的差异可以忽略。
C 与 C++ 写法对比
| 项目 | C 写法 | C++ 写法 |
|---|---|---|
| 整行输入 | fgets |
getline |
| 单词切分 | strtok |
stringstream |
| 单词保存 | 字符指针数组 | std::string |
| 去重方式 | 手动逐项比较 | set 或 unordered_set |
| 代码重点 | 内存与字符串边界 | 容器与抽象 |
易错点
- 不要使用
gets。即使题目说明中出现,也应换成fgets。 - 使用
fgets时要注意缓冲区是否能容纳整行输入。 - C 写法中保存的是指针,不能返回指向局部数组的指针,也不能在
line失效后继续使用这些指针。 - 题目假设全为小写字母。如果实际输入包含大小写,需要先把单词统一转换为小写。
set会自动排序,但这个排序不是题目要求,只是容器本身的有序特性。
小结
这道题有两个很典型的解法层次:
- 如果想练习 C 语言字符串和指针,可以手写切分与去重;
- 如果使用 C++,
stringstream + set能显著减少代码量,也更不容易出现缓冲区错误。
实际写程序时,应优先选择更安全、表达更直接的方案,而不是机械照搬题目中已经过时的输入函数建议。
- Title: 统计不同单词个数:C 与 C++ 的两种写法
- Author: Eviarch
- Created at : 2026-11-18 18:10:00
- Updated at : 2026-11-18 18:10:00
- Link: https://blog.eviarch.com/2026/11/18/统计不同单词个数/
- License: This work is licensed under CC BY-NC-SA 4.0.
Comments